IA
Dicter un compte rendu, garder l’enregistrement chez soi
Ce service transforme un enregistrement vocal en texte, sur les serveurs de l’équipe, et il est prévu pour tourner aussi dans les locaux d’un client. Il est né d’un besoin précis : dicter le compte rendu d’une séance de bilan de compétences, dont l’audio est la donnée la plus sensible du dossier.
Ce qu’elle fait
On envoie un fichier audio — enregistré sur un iPhone, en mp3, en wav… — et le service rend le texte. Il peut aussi rendre chaque segment avec son horodatage.
On peut lui fournir une amorce : quelques phrases avec le vocabulaire du métier. C’est le réglage le moins cher et le plus efficace. Sur une dictée de test, sans amorce, le modèle entendait « Rianek » ; avec l’amorce, il écrit « RIASEC », le nom exact du test d’orientation.
L’enregistrement n’est jamais conservé : il est effacé dès la fin de la transcription.
Pour qui
Pour un cabinet de bilans de compétences, ou tout professionnel qui dicte des notes confidentielles et ne veut pas les confier à un service en ligne. Pour toute application de la plateforme qui a besoin de transformer de la voix en texte.
Comment elle est construite
Le service s’appuie sur faster-whisper, une version optimisée du modèle de reconnaissance vocale Whisper. C’est un petit service écrit en Python, pas une application du socle Java.
- Une seule image tourne sur processeur Intel comme sur puce Apple. Elle s’installe depuis le catalogue du Hub, la plateforme qui héberge les applications. Elle est prévue pour tourner aussi sur une machine placée chez un client : l’audio ne quitterait alors jamais ses locaux.
- Le service parle le même langage que l’API de transcription d’OpenAI : une application déjà écrite pour ce format s’y branche sans adaptation.
- Il ne stocke rien et n’a pas de base de données.
- Deux réglages corrigent des défauts connus de Whisper, qui invente parfois des phrases entières sur un passage difficile : le service garde le filet de sécurité du modèle et l’empêche de propager une erreur au reste du texte.
Mesuré par l’équipe sur un processeur de 12 cœurs : une dictée de 20 secondes est transcrite en 14 secondes. Une séance dictée de 10 minutes est prête en 7 minutes environ, en tâche de fond.
Points forts
L’audio ne sort pas
Le service tourne sur les serveurs de l’équipe, et peut tourner chez le client. Aucun enregistrement ne part vers un fournisseur externe.
Le vocabulaire du métier
Une amorce de quelques phrases suffit pour que les acronymes et les noms propres soient écrits juste.
Moins d’inventions
Les réglages retenus empêchent le modèle de partir en boucle sur une phrase inventée. Un compte rendu entièrement faux est évité.
Rien n’est gardé
Le fichier audio est effacé à la fin de l’appel. Seul le texte est rendu.
En images
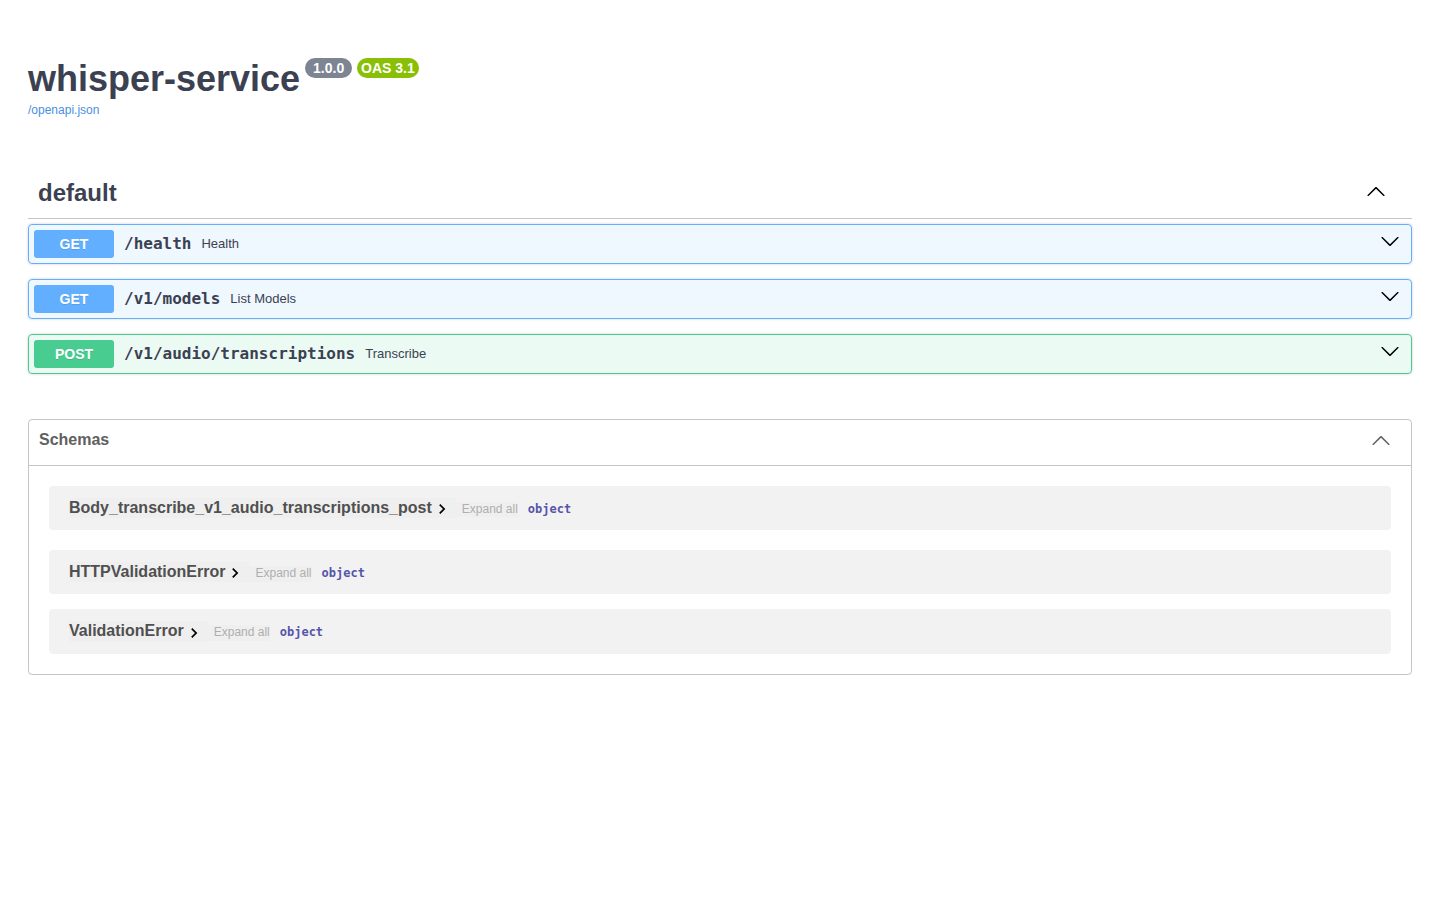
Écran 1
Le Swagger du service de transcription.
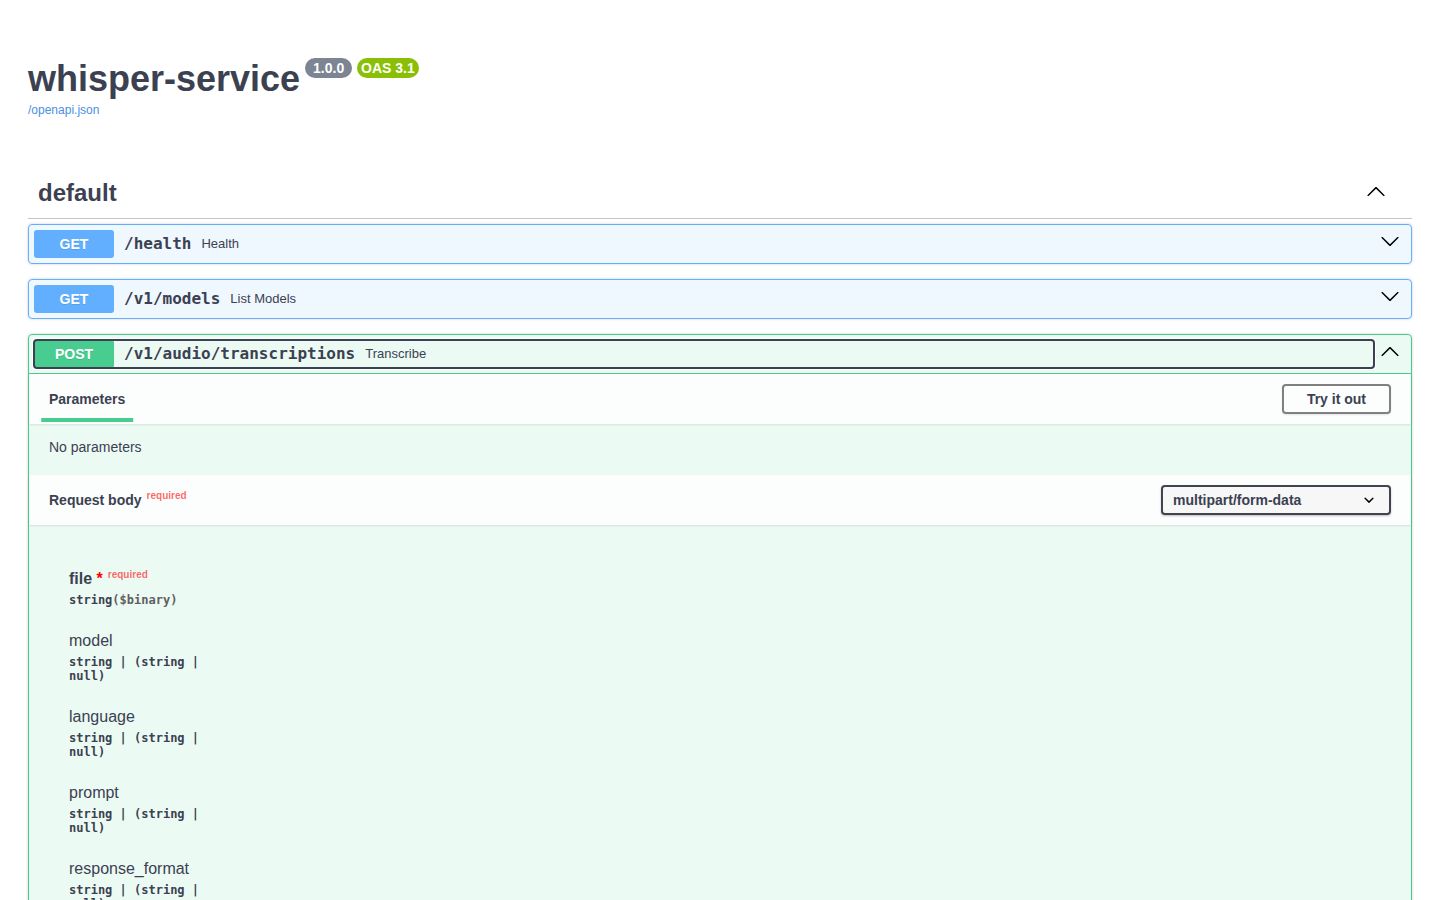
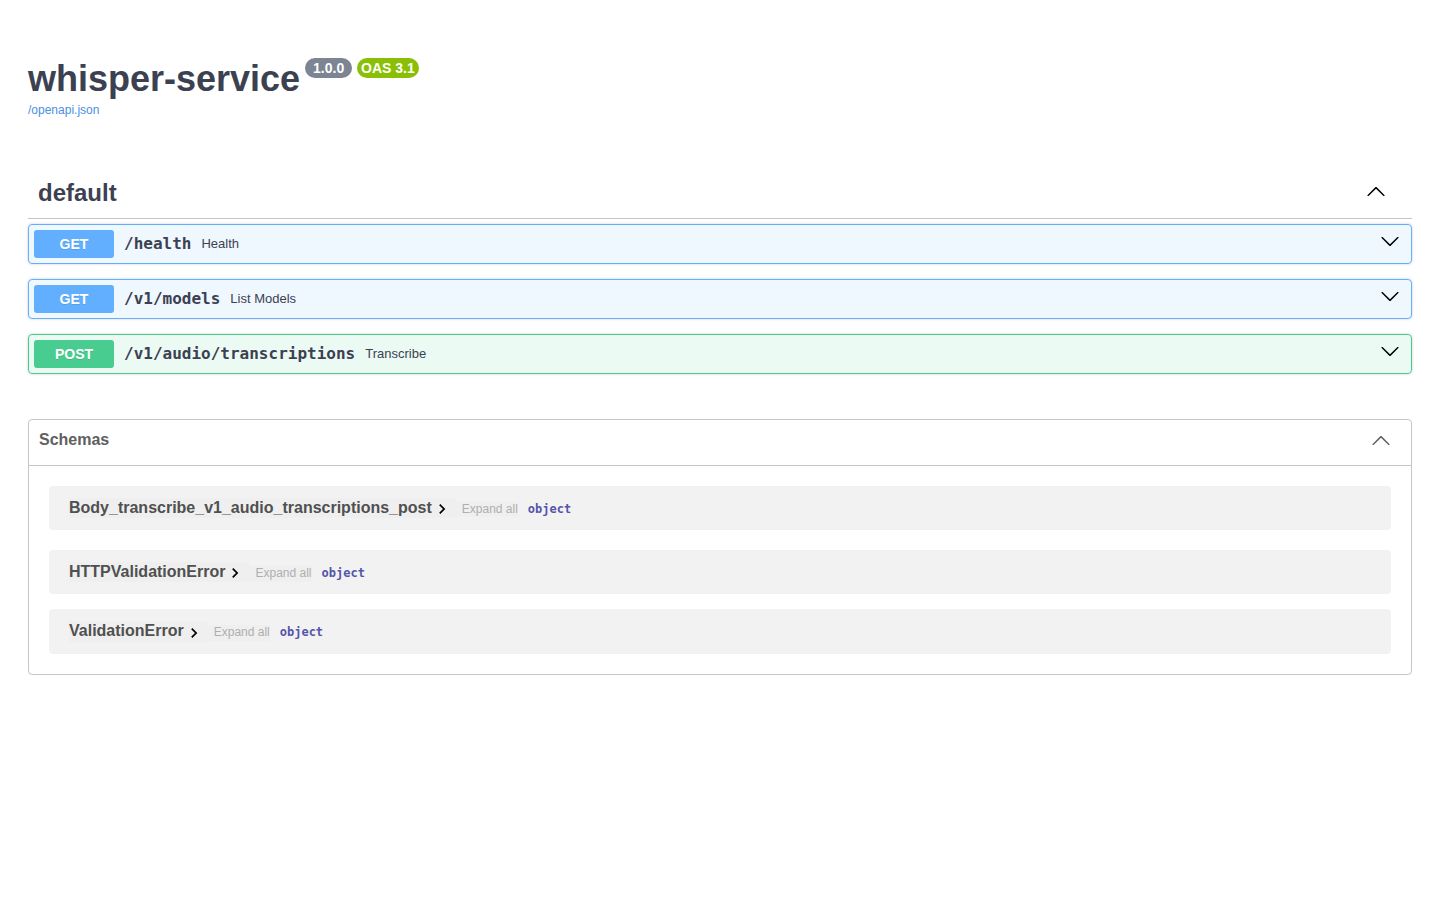
Écran 2
L’appel de transcription déplié.